Effiziente Konfiguration von ML-Experimenten mit Hydra
Hydra bietet eine leistungsstarke Lösung zur strukturierten Verwaltung von Machine-Learning-Experimenten und fördert Skalierbarkeit und Reproduzierbarkeit. Erfahren Sie mehr!
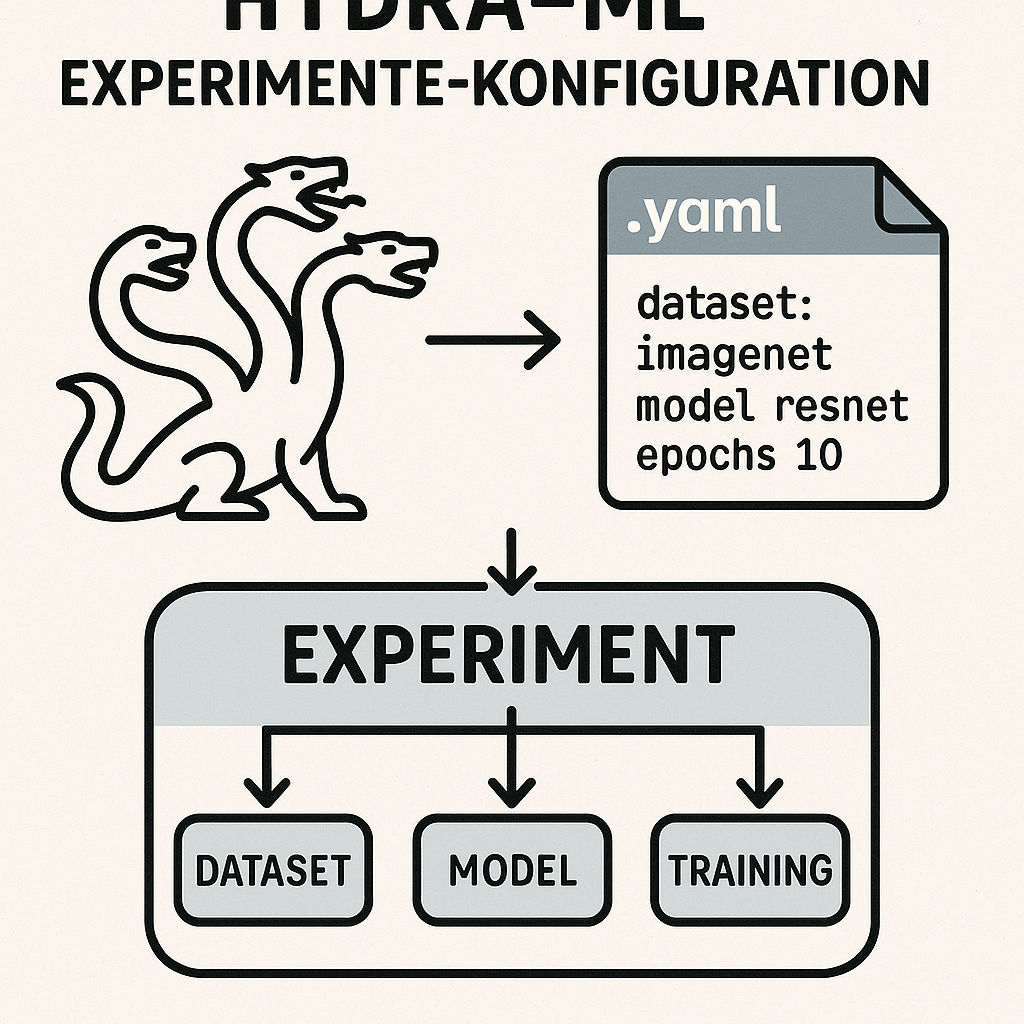
Hydra: Effiziente Konfiguration für ML-Experimente
Hydra, ein leistungsstarkes Rahmenwerk zur konfigurativen Verwaltung im Bereich maschinelles Lernen, wurde ursprünglich von Meta Research entwickelt und als Open Source bereitgestellt. Es ermöglicht die Entwicklung skalierbarer und reproduzierbarer Machine-Learning-Pipelines, indem es die Verwaltung von Experimentparametern optimiert. In diesem Artikel werfen wir einen genaueren Blick auf die Vorteile von Hydra und wie es die Forschungs- und Entwicklungsarbeit im machine learning Bereich unterstützt.
Strukturierte Konfigurationen mit Python-Datenklassen
Ein grundlegendes Merkmal von Hydra ist die Fähigkeit, strukturierte Konfigurationen mittels Python-Datenklassen zu definieren. Diese bieten eine saubere und modulare Art und Weise, um komplexe Parameter der Experimente zu dokumentieren und zu verwalten. Der Vorteil besteht darin, dass die Konfigurationen durch diese Art der Definition konsistent über mehrere Durchläufe hinweg bleiben. Diese Methode wird durch ein Python-Modul unterstützt, das essenzielle Werkzeuge für die dynamische Komposition und Verwaltung von Konfigurationsdateien bereitstellt Quelle.
Flexible und modulare Konfigurationen
Hydra ermöglicht es Forschern und Entwicklern, YAML-Konfigurationsdateien für Modelle, Daten und Optimierer programmatisch zu erstellen. Diese Dateien werden dann auf eine Weise zusammengeführt, die sowohl Flexibilität als auch Klarheit in der experimentellen Arbeit sicherstellt. Diese modulare Herangehensweise erlaubt es, verschiedene Konfigurationsstücke einfach zu kombinieren und anzupassen, um spezifischen Anforderungen gerecht zu werden Quelle.
Erweitertes Experimentmanagement
Eine fortgeschrittene Eigenschaft von Hydra ist die Unterstützung von Multirun-Simulationen für Hyperparameteroptimierungen. Über Kommandozeilen können Laufzeitanpassungen und Konfigurationsüberschreibungen vorgenommen werden, die ohne großen Aufwand die Parameter über verschiedene Läufe variieren lassen. Dies fördert nicht nur die Experimentgeschwindigkeit, sondern auch die Reproduzierbarkeit und erleichtert die Verwaltung großer Experimente Quelle.
Praktische Anwendung im ML-Workflow
Durch die Implementierung in realen Arbeitsabläufen integriert sich Hydra nahtlos in die Konfigurationssteuerung von Experimenten. Zum Beispiel demonstriert Hydra die Fähigkeit, Einstellungen wie Batch-Größe oder Lernrate programmgesteuert zu ändern und zu validieren, was den gesamten Prozess der experimentellen Verwaltung vereinfacht und effizienter macht. Die systematische Validierung der Konfigurationen stellt sicher, dass Fehler frühzeitig erkannt und behoben werden Quelle.
Zusammenfassend bietet Hydra einen effizienten Ansatz zur Verwaltung von Maschinenlernexperimenten, indem es Kompositionen struktureller Konfigurationen erleichtert und gleichzeitig flexible Anpassungen während der Laufzeit ermöglicht. Forscher und Entwickler profitieren gleichermaßen von dieser Methodik, da sie sowohl die Skalierbarkeit als auch die Reproduzierbarkeit ihrer Arbeiten steigert.